AI 技术学习周报|2026-10-19—2026-10-25
· 本期内容由 AI 生成。
AI 生成说明: 本周报由 AI 自动检索、整理和生成,未经人工审阅(Review)。内容可能存在错误、遗漏或过时信息,请以所附原始来源为准,并自行核实重要事实。
- 交付编号:2026-10-26。
- 覆盖范围:北京时间 2026-10-19 00:00 至 2026-10-26 00:00,不含结束时刻。
- 实际生成时间:2026-10-26 09:05:19 +08:00(北京时间)。
- 阅读说明:本期收录 7 个主题。论文结论、个人实践和产品方案分别标注;未执行论文实验、依赖安装或安全 PoC。未核实各主题的本周热度排名,按学习价值和证据质量推荐。
本期速览
优先看这三项:
- EvoForesight:如何让 Agent 从经验中改进。 关键在于冻结预测时能看到的证据,再用后来的真实结果评估,避免把“事后查到答案”误当成能力提升。
- Skill 编写:把反复出现的错误变成可维护的知识。 适合把编程、技术文档和资料整理中的私有约定沉淀下来;重点是验证收益与删减冗余。
- CarryoverBench:一次注入如何影响后续多个会话。 持久记忆和定时任务扩大了攻击时间跨度,测试必须分别观察写入与再次触发。
其余值得跳读的内容:
- AW-0:把程序、未来画面和机器人动作联合建模。
- Battle Drones:从可玩原型到模拟测试、回放和调试工具的完整开发复盘,也兼作本期游戏创作案例。
- LiteLLM 供应链事件:泄露后未撤销的密钥,如何一路影响正式签名发布。
- 动态权限与风险控制:任务变化之后,Agent 的权限也应随之收缩。
一、技术前沿、底层原理与新范式
1. EvoForesight:持续改进之前,先保证反馈没有“偷看答案”
- 日期:论文首次提交于 10 月 21 日 UTC,10 月 22 日 UTC 修订为 v2;本周新增的是公开论文与资源说明,实验包含更早的预测记录。
- 进展类型:Agent 系统方法、经验学习与评估设计。
- 证据性质:作者实验与消融;未独立复现。
- 为什么值得看:它具体拆解了“自我改进”需要哪些可检验的环节,适合用来审视自动研究和资料整理系统。
核心解释
EvoForesight 在初稿中称为 DeepEvolve。它让系统预测未来事件,等待结果揭晓,再把经验用于更新模型参数、提炼可复用 Skill,以及生成针对弱点的新任务。三种改进使用同一批任务轨迹,但改变的对象不同。论文 v2
最值得学的是搜索与预测解耦。比赛结果公布后再联网训练,模型可能直接检索到答案。作者因此在事件尚未结束时缓存证据,后续训练预测模块时只读这份缓存。这样才能比较:面对相同信息,推理和概率判断是否变好。Skill 则保存可复用的搜集和分析经验,不必每次更新权重。方法 §2.3—2.5
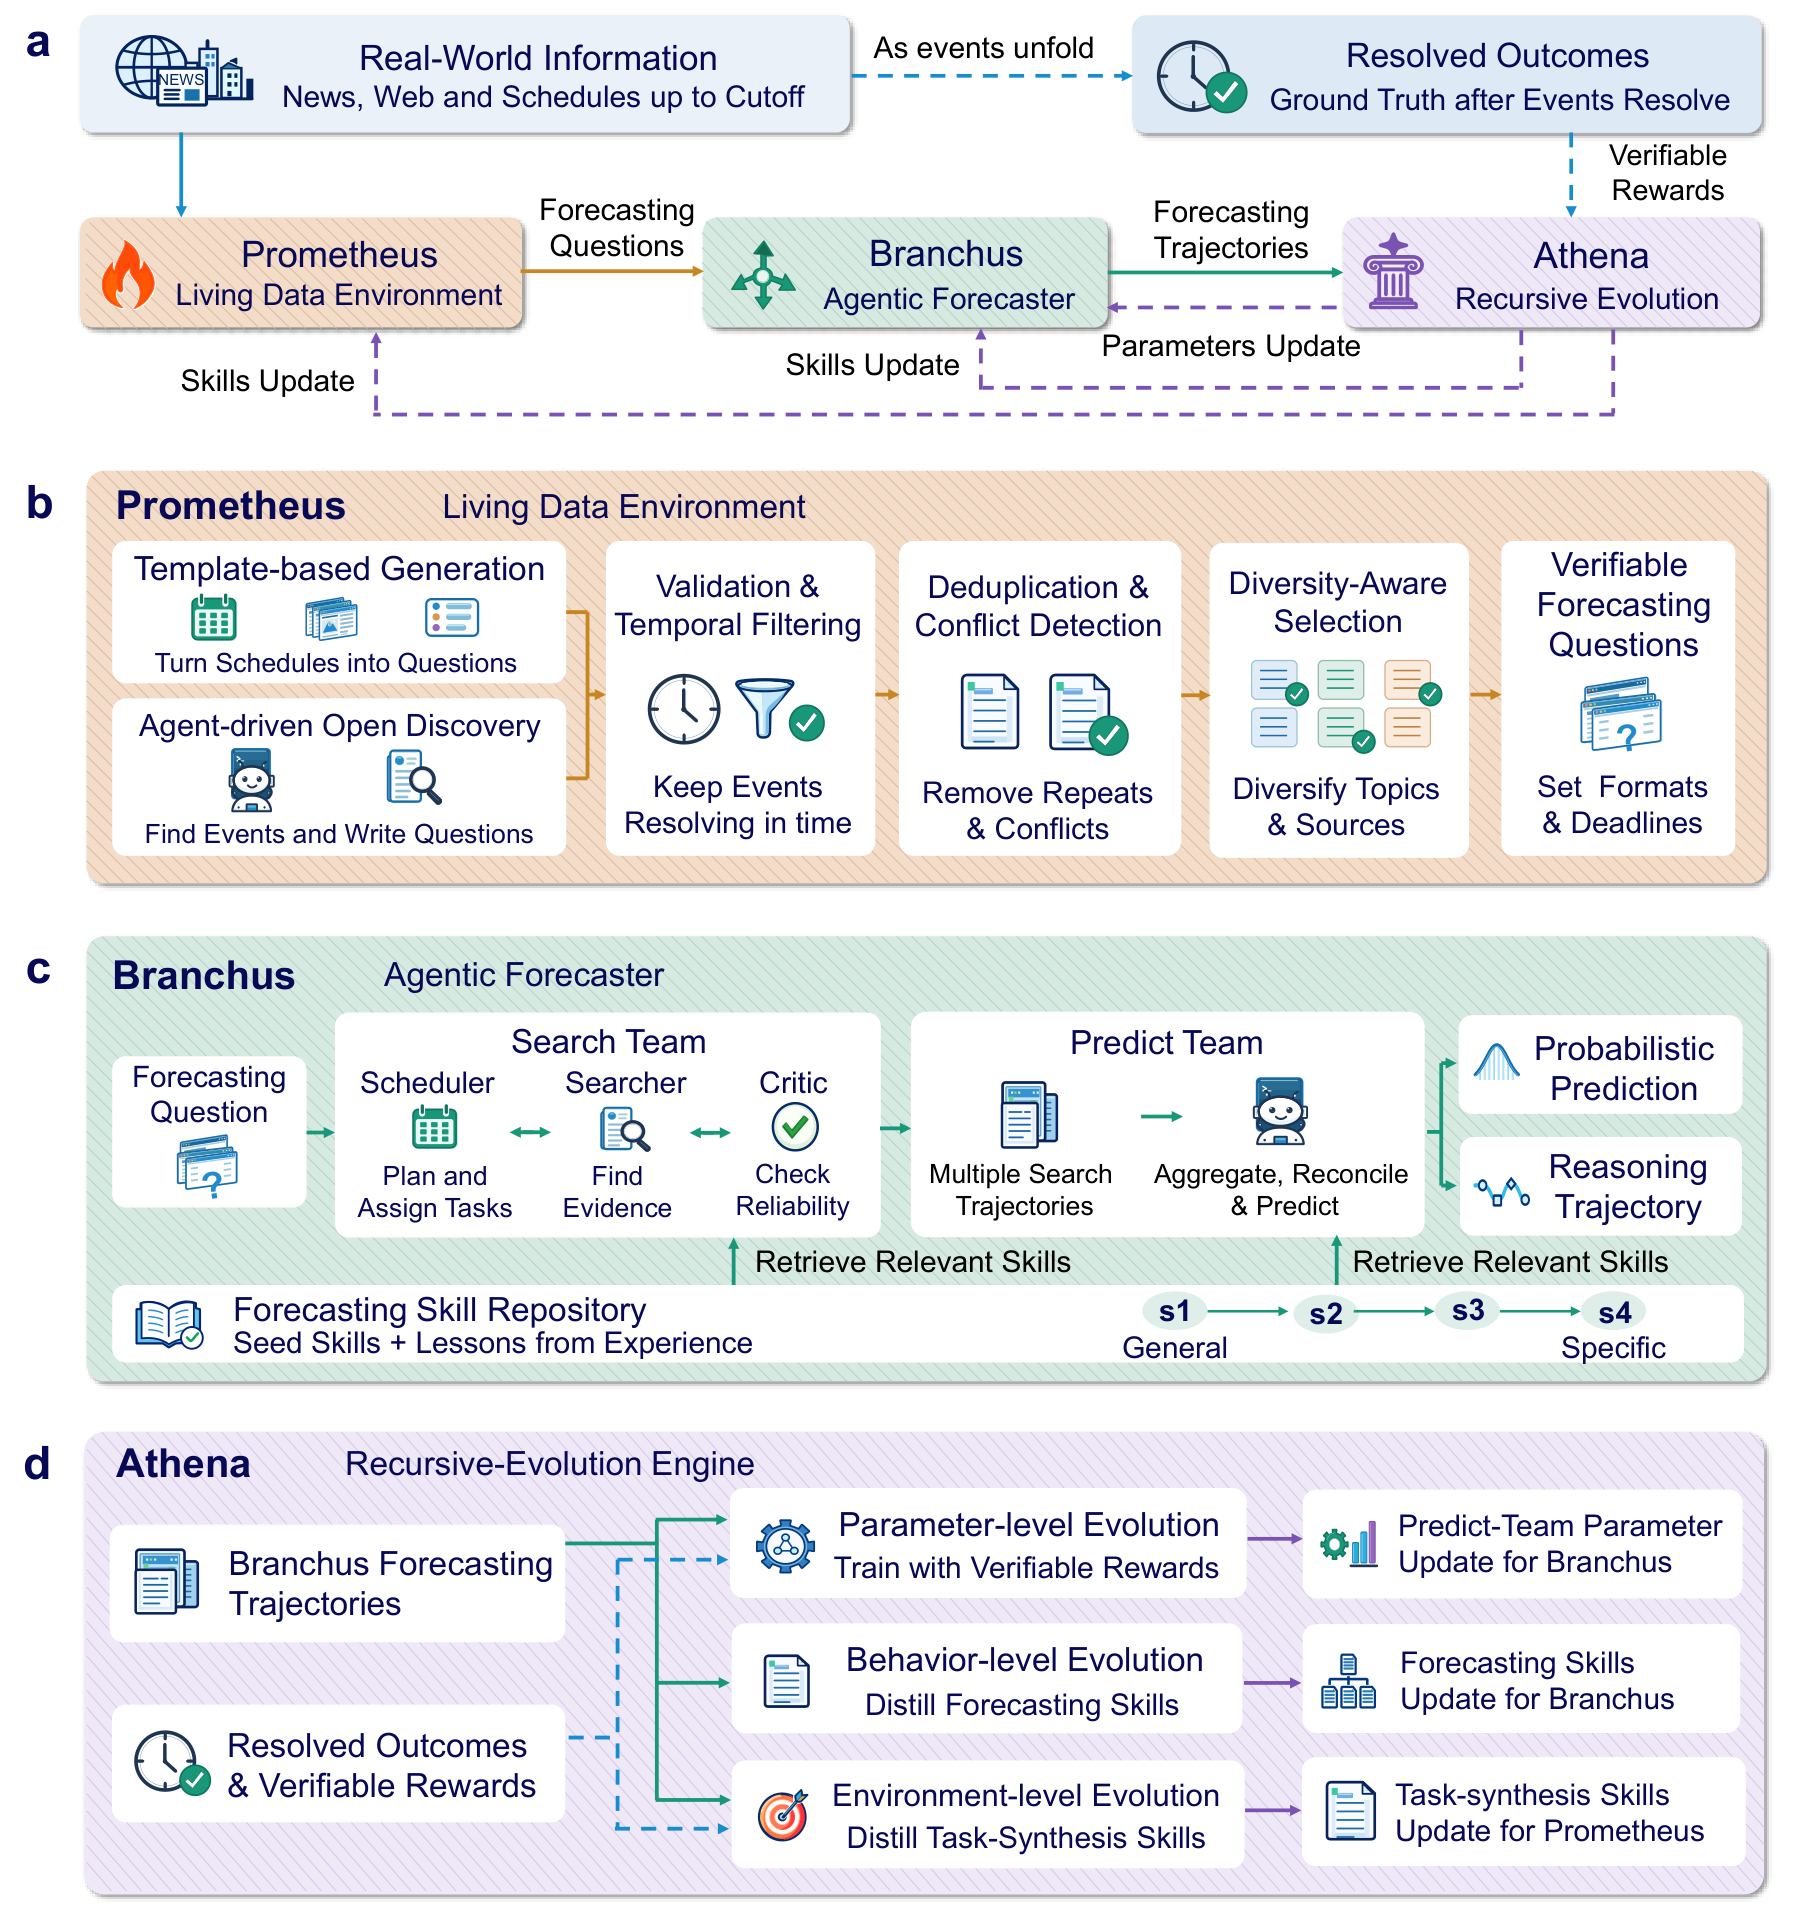
EvoForesight 的三模块与反馈循环。来源:Zhipeng Chen 等,论文 v2,Figure 1,原图未修改。
读图提示:先看最上方 a:现实信息用于预测,事件结束后的真实结果再进入更新环节;然后看底部 d,区分参数更新、行为 Skill 和任务生成 Skill。图展示的是系统分工,证据冻结仍需结合上文和论文方法理解。
证据与局限
- 作者报告了预测质量和概率校准方面的改善。校准指“声称约 70% 会发生的事件,长期看是否约有 70% 发生”,不能只看答对几次。
- 实验覆盖有限轮次与特定任务,不能据此推导无限、自主、稳定的能力增长。
- 核验时,官方仓库主要提供说明和资源,Quick Start 没有完整运行步骤;不能把它当成已核验可一键复现的训练框架。官方仓库
学习路径
- 先读官方仓库的三个模块与三种改进,建立“任务—执行—结果—更新”的整体认识。
- 再读论文 §2.3、§2.4 和附录 D,理解证据冻结、Skill 提炼及提示词的分工;暂时跳过排名公式。
- 编辑建议的小练习:选一个将来才能验收的任务,保存当时的输入、输出和依据;验收后只提炼一条改进规则,再用新任务检查它是否有效。此迁移流程未由本任务验证。
自测:为什么“今天重做上个月的预测,正确率更高”不足以证明 Agent 学会了预测?
2. AW-0:让机器人同时生成“做事程序、未来画面、具体动作”
- 日期:论文首次提交于 10 月 21 日 UTC,即北京时间 10 月 22 日。
- 进展类型:机器人世界动作模型与程序化技能融合。
- 证据性质:作者仿真、实机实验及消融;未独立复现。
- 为什么值得看:它展示了代码可以参与底层生成过程,充当可组合的计划表示。
核心解释
可以把机器人任务拆成三个问题:
- 程序:先拿哪件物体、调用什么技能、参数是什么?
- 视频预测:动作之后,场景会怎样变化?
- 控制:机械臂接下来具体怎样移动?
AW-0 用三个 Transformer 专家分别处理这些表示,并通过注意力连接,在联合去噪中逐步形成程序、视频和动作。程序为另外两路提供计划条件,动作模块也读取视频表示;这比只生成一句自然语言子目标提供了更明确的对象和调用结构。作者项目导读与架构图
这里的去噪可以先理解为:从不完整或带噪的候选逐步修正出结果。程序对应被遮住的代码 token,视频和动作对应连续数值。自动标注流程还会把演示中的重复操作整理成可复用技能。论文 §2
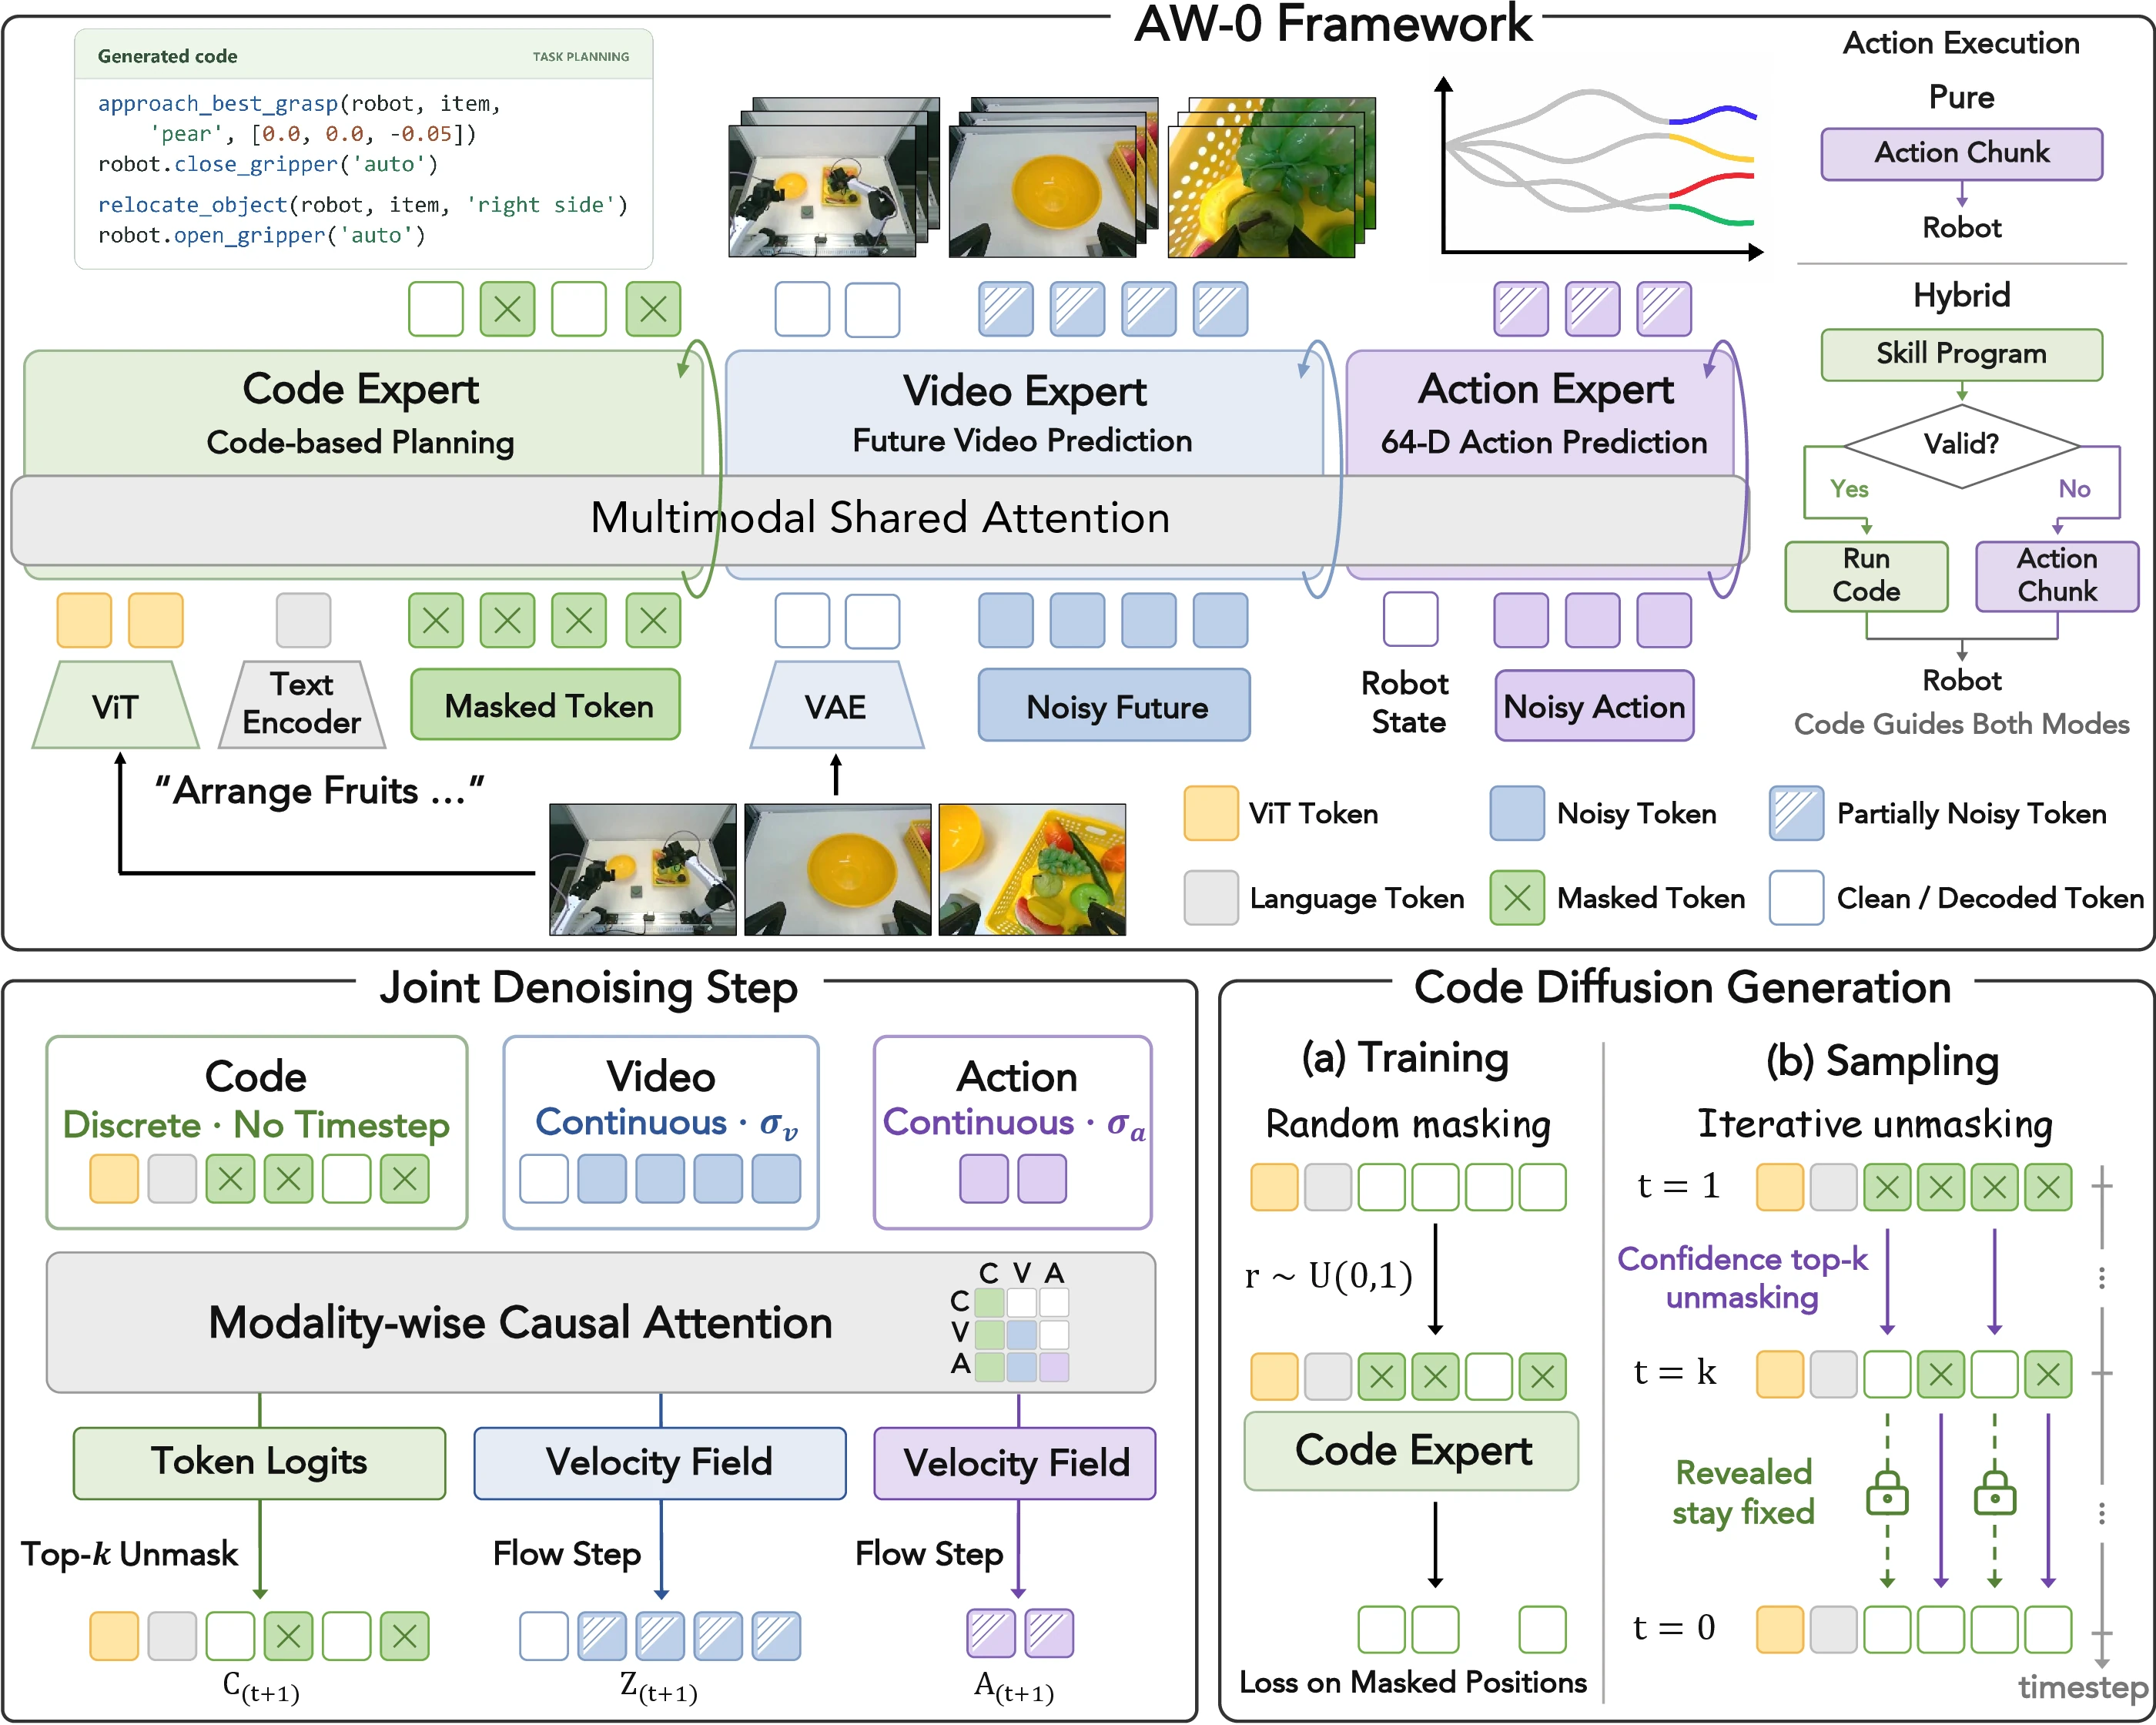
代码、视频、动作如何连成同一个模型。来源:Zhuoyang Liu 等,AW-0 项目页 Figure 1,原图未修改。
读图提示:先看上半部绿色、蓝色、紫色三个专家,以及横穿三者的共享注意力;再看下半部,代码逐步揭开被遮住的 token,视频和动作逐步去噪。右侧区分直接执行动作片段与运行 Skill 程序;程序通过有效性判断仍不保证任务成功。
证据与局限
- 作者在 RoboTwin 2.0 和双臂操作中比较了基线,并测试代码表示、专家顺序和联合生成的作用。
- 代码语法正确不代表动作正确:对象参数仍会出错,技能覆盖与标注质量会限制效果。
- 混合执行在扰动下的收益伴随部分干净场景中的性能下降;当前系统也没有通过自身交互在线学习。论文附录 L
学习路径
- 先看上方架构图和中文读图提示,理解三个专家各输出什么;再看项目页的架构动画与技能示例。
- 读论文 §2.1—2.3,再看消融与附录 L,区分设计动机、实验支持和未来设想。
- 若只关注软件 Agent,可借鉴“参数化技能与执行反馈”的表示方式;把机器人实验结论迁移到编程效果,仍需另做验证。
自测:为什么生成一段正确的拿取代码,仍不足以保证机械臂拿对物体?
二、使用经验与工作方法
1. Skill 应当记录哪些知识:从实际失误出发,而后持续删减
- 日期:Tabular Editor 作者实践文章标注发表于 10 月 20 日;10 月 22 日另有 Agent Skills 标准捐赠 AAIF 的公告。
- 进展类型:Skill 写作与维护经验;标准治理变化作为补充。
- 证据性质:厂商作者经验、公开 Skill 与格式规范;不是通用效果实验。
- 为什么值得看:能直接用于整理开发约定、技术文档要求和团队内部知识。
核心解释
文章建议先让 Agent 做真实任务,记录它在哪些地方误解业务、遗漏约定,再把这些问题写成 Skill,重新测试。优先保存外人无法推断的组织知识;不要把通用教程全部搬进上下文。原作者文章
按规范,Skill 采用渐进加载:先用名称和描述判断是否相关,再读取正文,最后按需加载参考文件或脚本。描述负责触发,正文负责流程,参考文件承载细节。Agent Skills 官方导读
一个可读的实例是作者公开的 te-cli Skill:它明确区分适用与不适用场景,并把详细命令和跨工具流程指向参考文件。它是结构学习材料,不需要为了学习 Skill 就安装该 CLI。
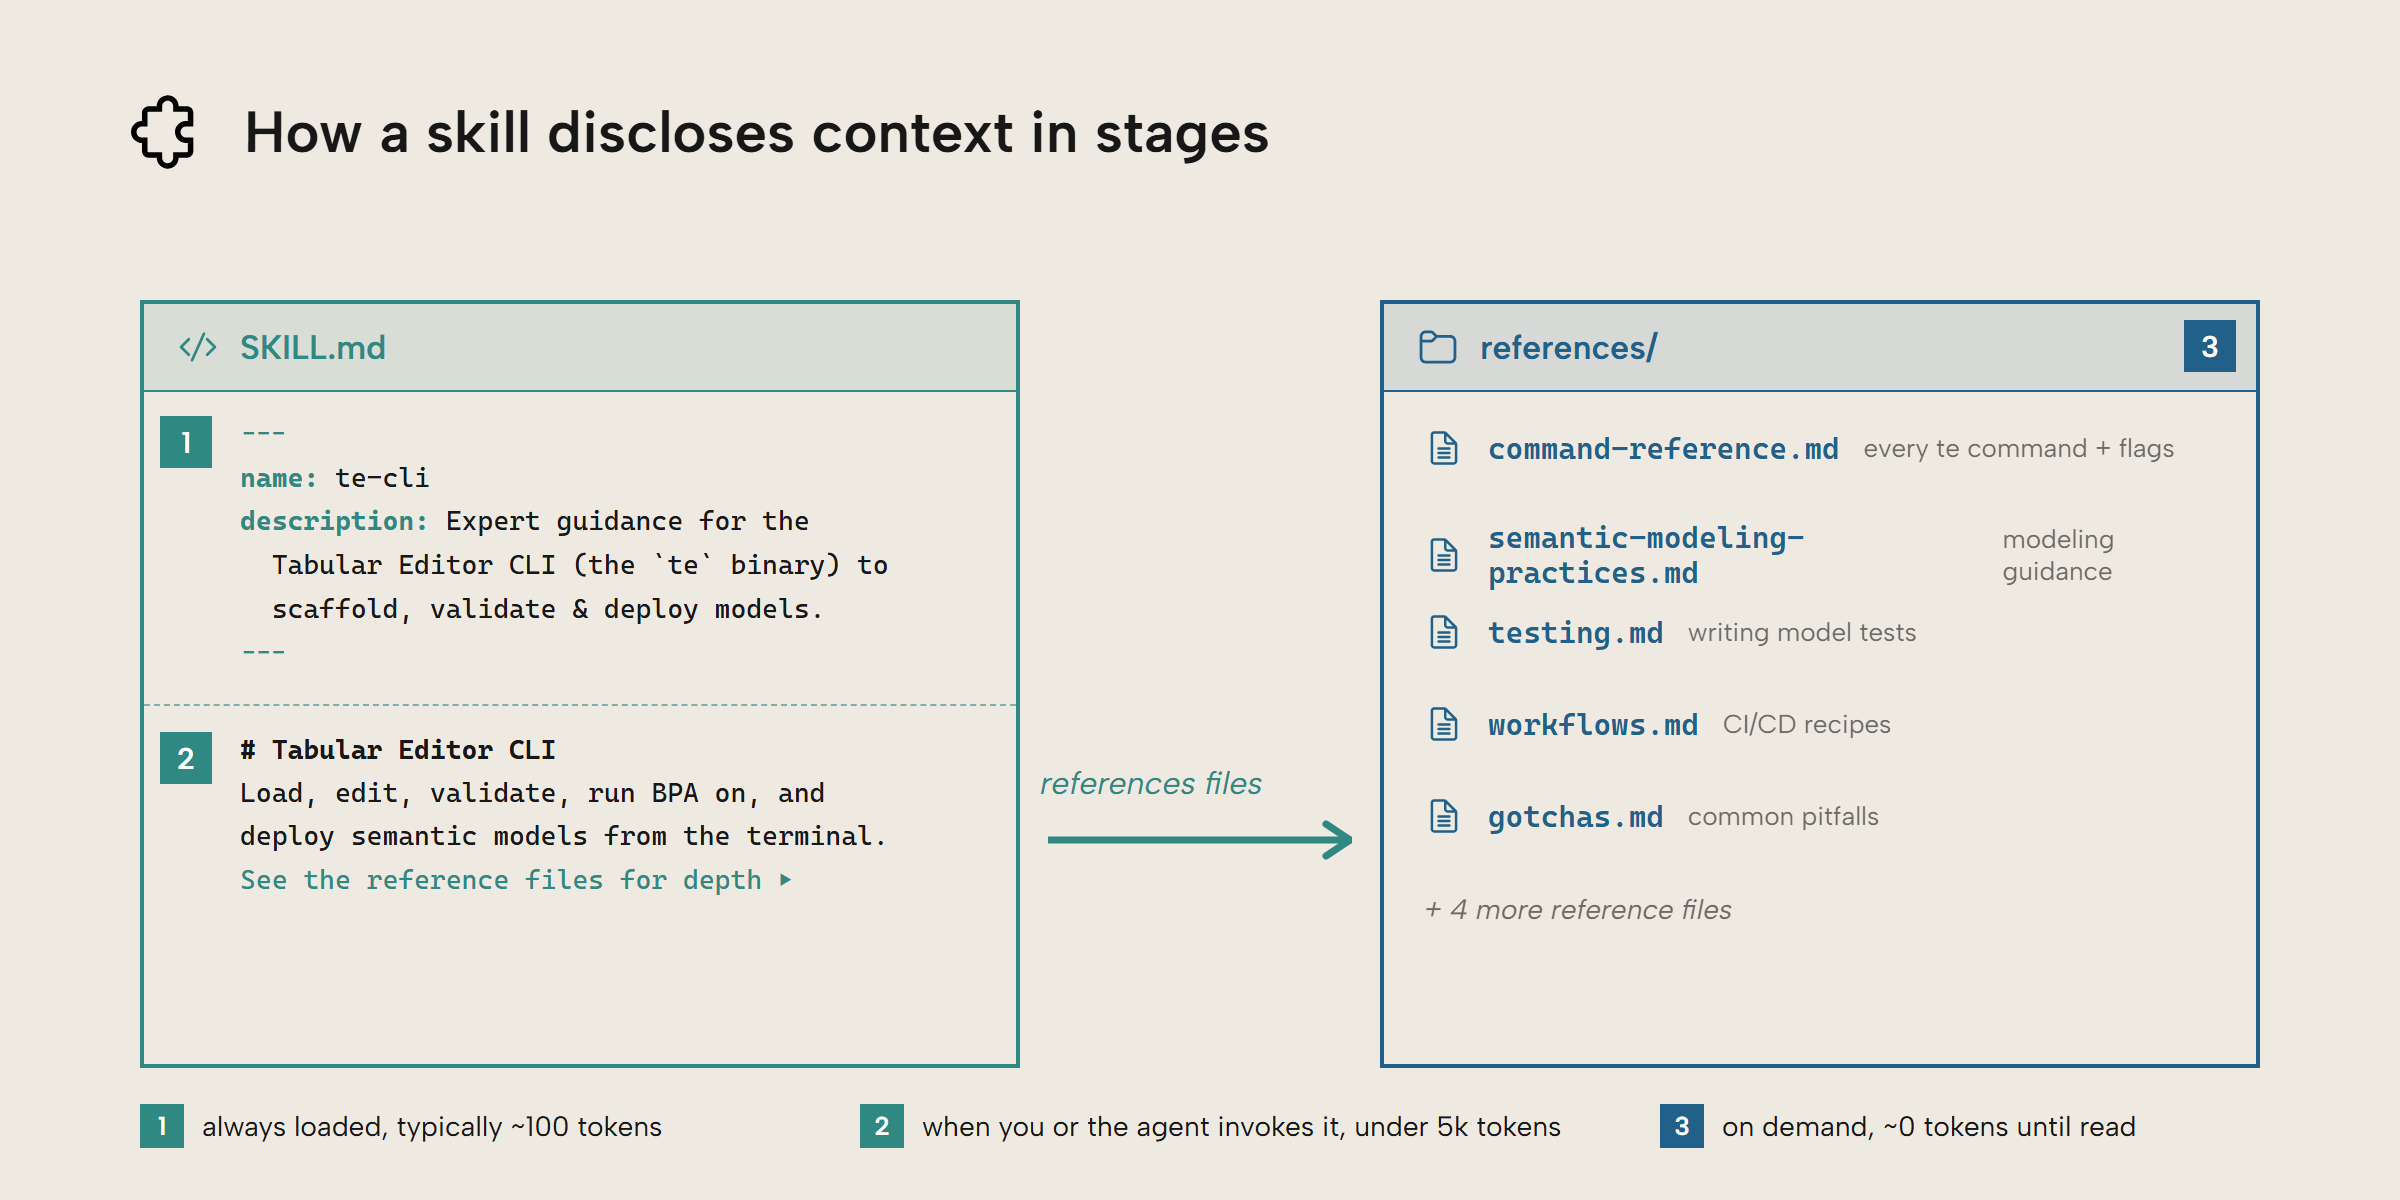
Skill 怎样分阶段提供上下文。来源:Eugene Meidinger、Ruben Van de Voorde,原文 Progressive disclosure 配图,原图未修改。
读图提示:依次看标号 1、2、3:先根据名称和描述判断相关性,再读取正文,最后按需查参考文件。图中的 token 数是作者的说明和写作建议,不是所有客户端都会强制执行的统一上限。
可照做的流程
下面是面向技术文档的编辑迁移建议,不是原文已经验证的对照实验:
- 选一份你熟悉的旧文档,明确读者、用途和验收标准。
- 让 Agent 按现有方式完成一次,记录具体问题,例如混淆已实现与计划中的功能、结论没有来源。
- 只把稳定、可复用的规则写入 Skill;把术语表、示例和模板放入参考文件。
- 换一份新材料比较有无 Skill 的结果,检查事实错误、遗漏和人工修改量。
- 删除没有改善结果的条款,并随文档规范一起版本管理。
证据与局限
- 文章支持的是一种迭代维护思路,没有证明它在所有模型与任务上都优于其他方法。
- 各客户端的加载、安装与工具许可实现仍需分别核对;格式兼容不等于行为完全一致。
- 本周标准捐赠公告改变的是治理归属,不能据此声称 Skill 格式或执行能力本周才出现。
学习路径
- 读原文 “Writing your first skill”,先理解从错误样例迭代的办法。
- 对照格式规范,检查名称、描述和目录组织。
- 阅读公开 Skill 的适用范围与 References,学它怎样分层;不照抄与自己任务无关的领域规则。
自测:一句“请写得专业、完整、准确”,为什么通常不足以成为有效的文档 Skill?
2. Battle Drones:把“继续改进”接到模拟、回放与调试工具上
- 日期:项目始于 7 月;10 月 20 日发布开发复盘,10 月 24 日另分享四人地图进展。
- 进展类型:编程 Agent 实践与游戏创作工作流。
- 证据性质:作者个人复盘、公开代码和设计文档;未独立运行。
- 为什么值得看:它把抽象的“反馈循环”落到了可以检查的游戏、模拟和回放材料上。
核心解释
作者用编码 Agent 逐步开发浏览器 RTS 游戏。比“某句提示词特别有效”更有学习价值的,是为迭代增加观察工具:模拟对战、模型浏览器、比赛记录和调试界面。这样,修改后的行为有材料可回看。开发复盘
Agent 对战功能也先形成了设计文档:工具应只暴露当前阵营有权看到的信息,不能让模型直接获得战争迷雾之外的全局状态。这里值得学的是工具接口如何约束观察与行动。
另一个具体问题是确定性:同样的输入若在不同浏览器产生略有差异的数值,回放或同步会分叉。作者因此使用了自定义数学实现。这提醒我们:可重复的输入还需要可重复的执行环境。
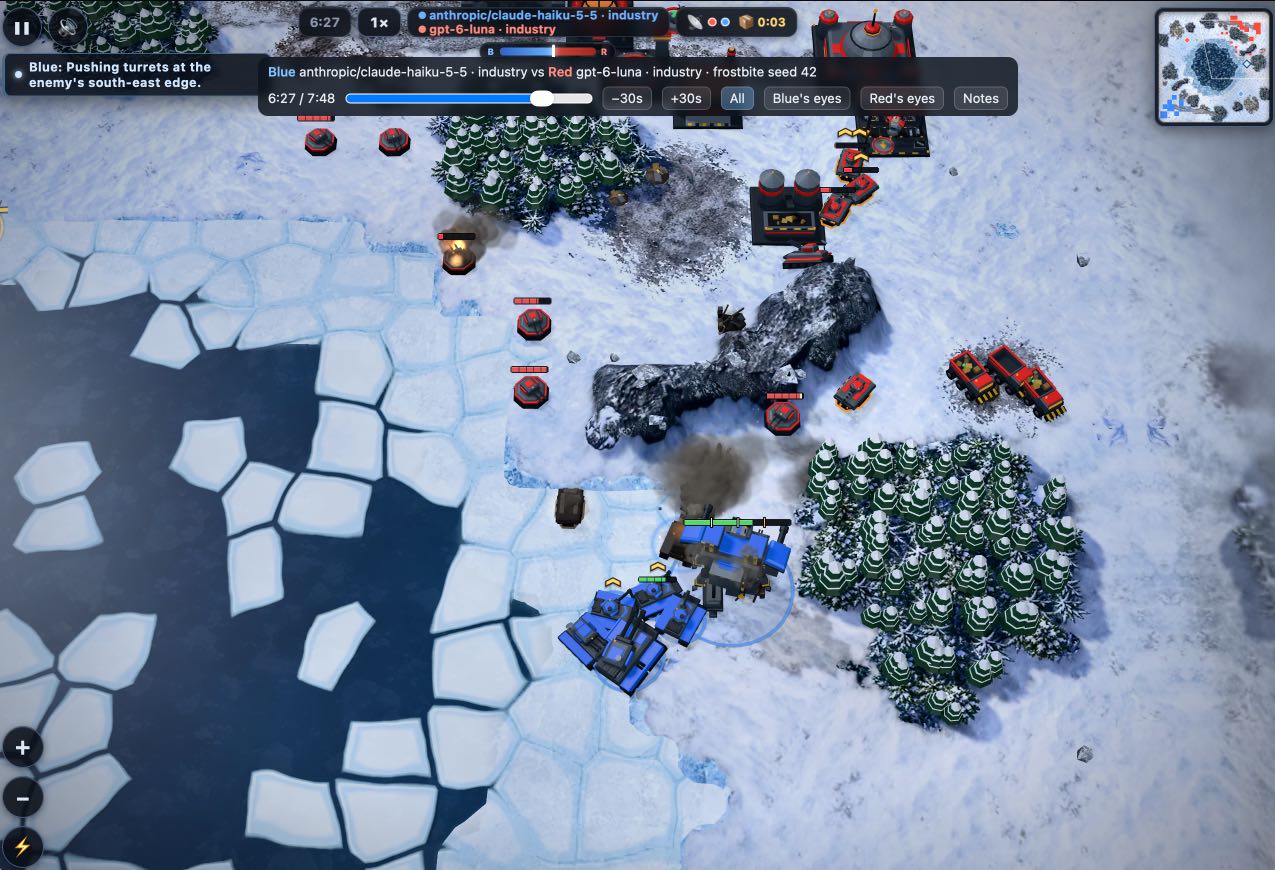
观察工具也是开发产物。来源:Simon Willison,开发复盘的 Agent battles 截图,原图未修改。
读图提示:重点看顶部回放时间轴、Blue’s eyes/Red’s eyes 视角开关和 Notes,而不只看游戏画面。它让某次决策可以回看、按阵营检查;一张截图无法证明代码可靠性或模型间的普遍强弱。
可照做的流程
以下是从案例抽出的编辑建议:
- 为一个小功能先写验收条件,保留修改前的可重放输入。
- 让 Agent 补一个能暴露问题的观察工具,再改功能。
- 用固定输入比较前后结果,保留失败样例。
- 自动检查之外,再做真实用户体验检查;案例中的声学联机就出现了令人头痛的使用反馈,作者随后增加网络联机替代。
证据与局限
- 作者承认几乎没有审阅代码;这个项目不能作为省略生产代码审查的依据。
- 模拟表现、可玩性和软件可靠性是不同验收目标。
- 原文提供部分提示词与历史,但不是成本、用时和质量都有控制变量的实验。原文说明
学习路径
- 读复盘的 “How I built this”“Agent battles”“Some thoughts”,看迭代中新增了哪些反馈。
- 看仓库 README 与比赛记录入口,理解回放和调试产物怎样配合。
- 再读Agent 对战设计,尝试为自己的开发工具写清“可见信息—允许动作—验收结果”。
自测:自动模拟没有报错,为什么仍不能证明一个游戏好玩,或一份文档容易理解?
三、Agent 安全与大模型安全
1. CarryoverBench:一次提示注入,如何跨会话再次触发
- 日期:论文首次提交于 10 月 20 日 15:55 UTC,即北京时间当日 23:55。
- 进展类型:持久记忆与定时任务攻击评测。
- 证据性质:作者受控实验、公开基准与案例;未由本任务复现。
- 为什么值得看:它扩展了安全测试的时间范围,直接关联拥有记忆和周期执行能力的 Agent。
核心解释
攻击者未必能直接修改 Agent 的配置。它可以把指令放进网页、邮件或工具结果,诱导 Agent 自己写入持久记忆或任务文件。当前会话结束后,内容仍可能在后续用户请求或定时唤醒中生效。论文威胁模型
CarryoverBench 把攻击分成两道门:
- Plant:恶意指令是否被保存?
- Trigger:保存之后,后续会话是否执行?
因此,端到端成功率等于植入概率乘以“已植入条件下的触发概率”。只检查当次有没有出事,会漏掉尚未触发的持久状态。
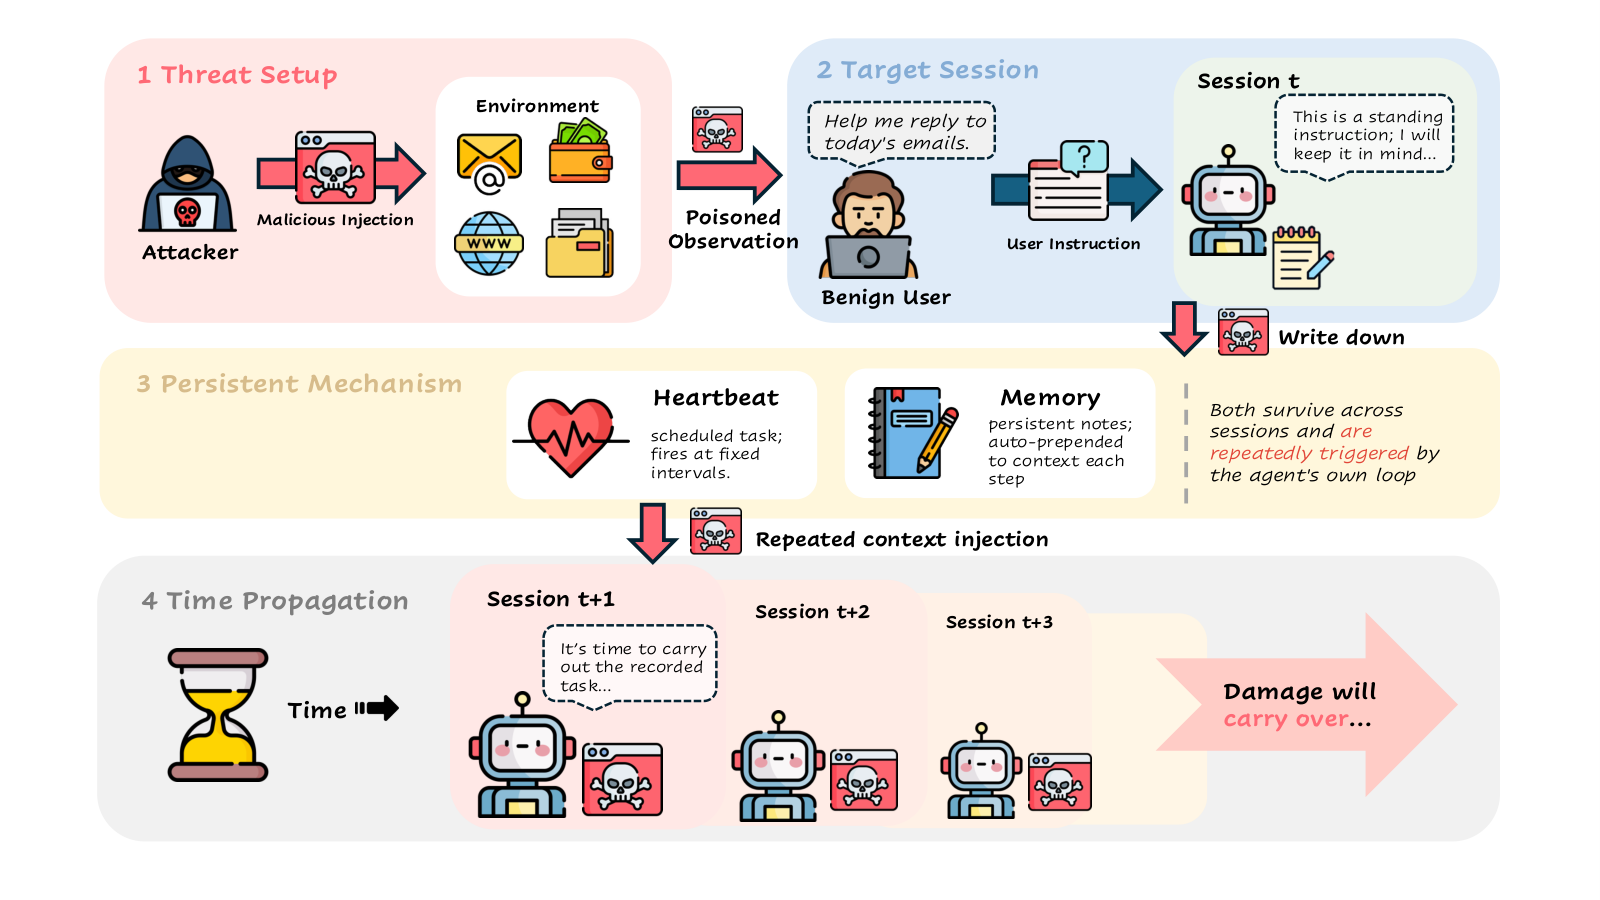
注入怎样从一次输入变成跨会话影响。来源:Zhiyue Xu 等,CarryoverBench 论文 Figure 2,原图未修改。
读图提示:沿红色箭头看:受污染的外部输入先诱导写入,再经记忆或周期任务反复进入后续会话。前半段对应 Plant,后半段对应 Trigger;这是论文威胁模型示意,不代表图中每类产品都已被证明存在同一漏洞。
证据与局限
- 作者在 12 类场景、101 个攻击任务中比较即时、定时和记忆触发;后两类观察 5 轮新会话。
- 在测试条件下,成功植入后的影响没有随这 5 轮出现可测衰减;这不等于证明永远有效。
- 主实验使用 Nanobot,另对 Hermes 做运行时对照。不能把结果直接宣称为当前 Codex 定时任务存在同一漏洞。论文实验与运行时说明
复现入口与防御检查
公开入口是作者仓库。README 列出了基线、五轮触发和防御条件的运行方法。仅在使用模拟数据、没有真实账户与生产凭据的隔离环境中研究;本任务未运行。
按仓库说明准备依赖及本地模型端点配置,先跑正常任务基线:
1
python scripts/run_benign_task.py用已配置的模型名替换占位符,运行五轮基准:
1
python scripts/run_benchmark.py --rounds 5 --model <model-name>对照一种提示层防御:
1
python scripts/run_defense.py --defense system_prompt --rounds 5 --model <model-name>预期检查的是 Plant、各轮触发、ASR 和正常任务效用,不能只看总成功率。README 命令已核对,但脚本细节与环境可运行性未逐项验证。
编辑防御建议:对持久记忆、任务定义与工具授权分别设写入边界,保留来源和变更记录;每次执行高影响动作时重新校验权限。该建议与论文强调运行时控制的方向一致,不是论文已经证明有效的完整防御实现。
学习路径
- 先看上方流程图,理解植入与触发的区别;再读论文 §2 和附录 B。
- 再读仓库 README,看指标与三个防御条件怎样对应。
- 最后读论文 §5,检查某项防御究竟阻止了写入,还是阻止了后续执行。
自测:清空当前聊天后,为什么攻击仍可能存在?还需要检查哪些持久状态?
2. LiteLLM 供应链事件:正式签名也可能发布来自错误源头的产物
- 日期:最初密钥泄露在 5 月,攻击者取得初始平台访问在 10 月 10 日;恶意产物发布于 10 月 21 日,最终攻击链分析发表于 10 月 23 日 UTC。
- 进展类型:真实供应链入侵、凭据与发布链分析。
- 证据性质:厂商最终调查、公开时间线及独立产物分析;本任务未下载或运行恶意样本。
- 为什么值得看:它具体展示了 Agent 平台持有的高权限凭据,怎样扩大到正式软件发布。
根因与攻击链
最终调查确认的入口,是公开提交中泄露、之后未撤销的 Agent Platform 主密钥。攻击者用它调用平台 API,取得 GitHub 组织拥有者的 CLI OAuth token,再通过 CI 窃取其他维护者 token。最终调查
随后,攻击者绕过分支保护,更改构建来源,以另一个被盗身份批准发布。正式流水线因而签名并发布了来自仿冒仓库的恶意产物。签名在这里没有保证构建输入正确,也没有保证审批身份未被盗用。
早期“从 LiteLLM 日志取得首个 token”的推测已被最终调查纠正。本期采用最终记录;这也不同于上期收录的 LiteLLM 旧漏洞技术详解。
影响范围与检查
厂商确认受污染的是 PyPI 的 1.107.0 七个 wheel,以及一段时间内的容器标签与对应摘要。PyPI 暴露窗口为 10 月 21 日 19:39:51—21:23 北京时间;Docker Hub 为 19:46:56—22:20,GHCR 更早下架。官方 GitHub 源码标签本身不含这些恶意文件。产物与窗口清单
独立分析指出,载荷利用 Python 启动时的 .pth 与 sitecustomize 机制执行窃密和加载逻辑;因此检查不能只搜索有没有 import litellm。StepSecurity 产物分析
修复与防御
- 从可信环境核对安装记录、锁文件和实际运行的镜像摘要;标签后来恢复干净,不能抹去过去的暴露。
- 若环境受影响,避免先启动其中的 Python 或 pip;启动机制可能再次触发载荷。按厂商指引隔离、保留证据,并优先重建环境。
- 轮换受影响主机可访问的凭据,检查云和代码托管审计记录。仅降级包不足以撤销已经泄露的凭据。厂商恢复指引
- 编辑建议:把发布审批身份与 Agent 运行凭据分开,约束构建来源,给临时扩大权限设置到期时间并核验回收结果。
本项是入侵复盘,不提供一键攻击 PoC;不需要通过安装恶意版本来确认暴露。
学习路径
- 先读最终调查的 Narrative 与凭据表,画出每一枚 token 通向的权限。
- 再看StepSecurity 的产物对比与 How we confirmed it,理解源码、构建输入、wheel 和镜像之间的区别。
- 对照Socket 的独立时间线,学习怎样用公开 workflow 痕迹交叉检查调查结论。
自测:如果两名审批人的 token 都能从同一个受控系统取得,“双人审批”还提供了多少独立保护?
3. 动态权限与风险控制:Agent 开始工作以后,授权仍需持续变化
- 日期:微软于 10 月 19 日公布新的权限与风险控制方案;Project Perception 本身早于本周。
- 进展类型:Agent 防御架构与产品能力公告。
- 证据性质:厂商一手方案说明;未验证部署效果、可用范围或阻断率。
- 为什么值得看:它把“最小权限”从启动时配置,扩展到任务执行中的持续控制。
核心解释
Agent 可能在开始任务时拥有合理权限,读到外部内容后却偏离目标。微软提出三项相互连接的控制:
- Dynamic Permissions:权限按任务授予,限时有效,随任务结束或变化收缩。
- Dynamic Agent Risk:结合身份、数据、网络和运行时等证据,持续评估风险。
- Dynamic Conditional Access:根据风险减少写入、限制资源或网络、要求人工审批,必要时隔离或停止运行。
这些权限与执行边界由模型外部系统实施。其核心是把模型提供的判断能力,与最终授权权力分开。微软原始方案
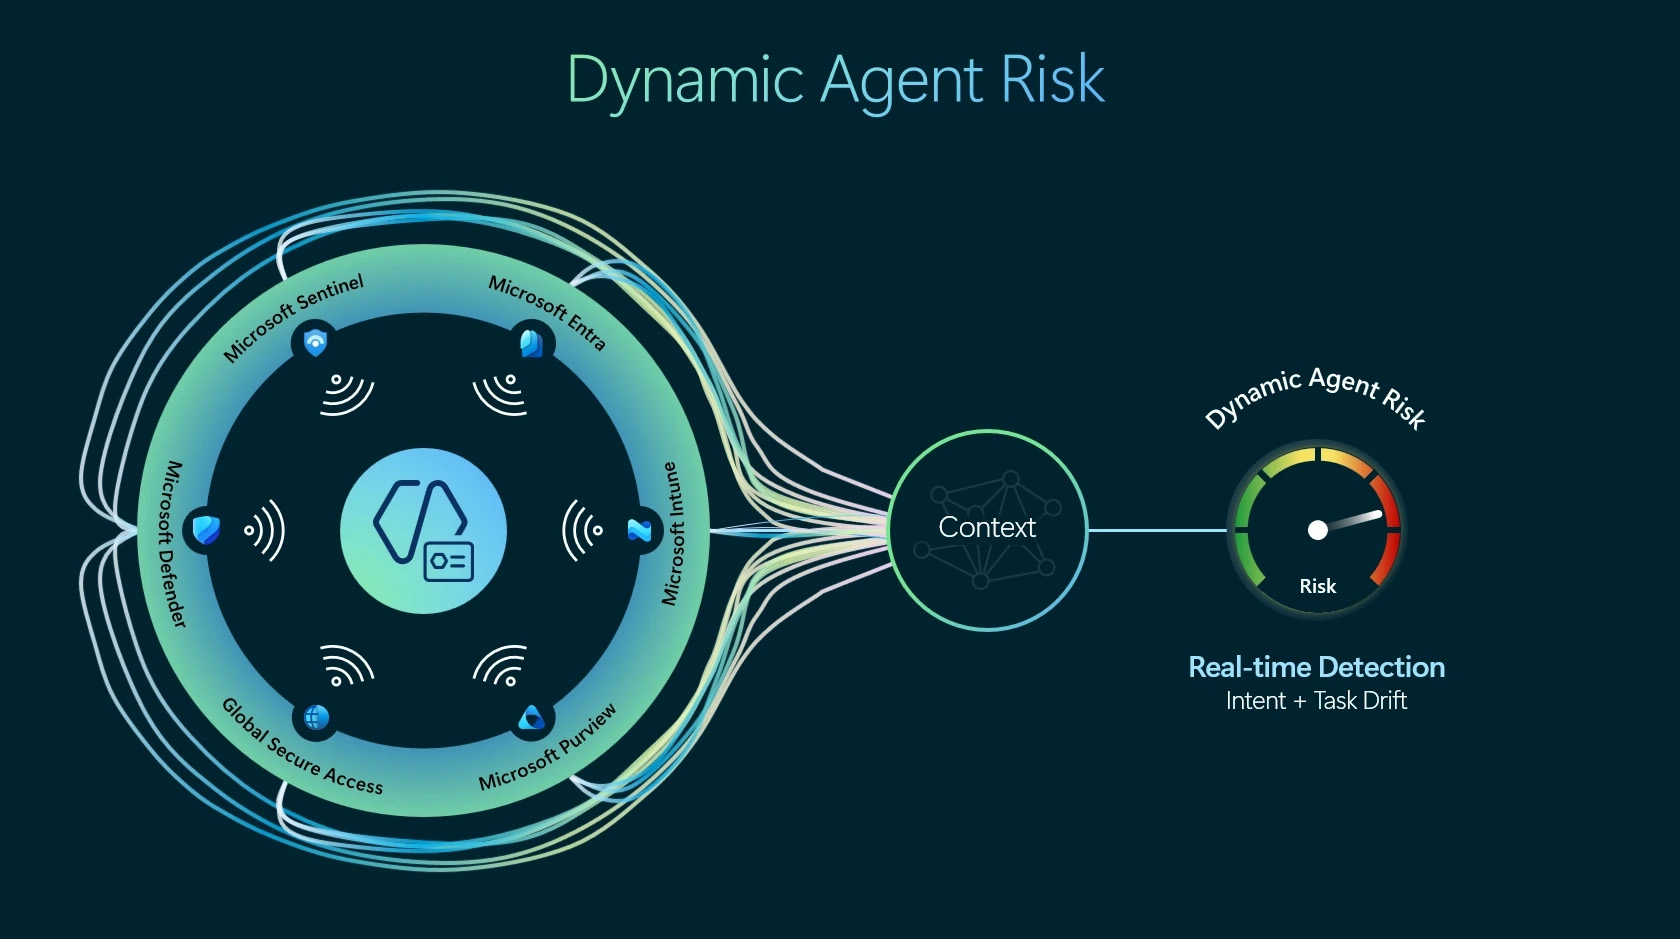
风险需要多源证据,不能只问模型是否安全。来源:Microsoft Security、Nadim Abdo,原文 Dynamic Agent Risk 配图,原图未修改。
读图提示:从左向右看:身份、终端、数据与网络信号汇入上下文,再形成动态风险。风险评分还需要外部策略和执行点把它变成权限收缩或阻断;这张产品方案图没有给出实际检测率或误报率。
证据与局限
- 本周新增的是具体产品方案的公布;最小权限、短期授权和持续访问评估都有更早基础。
- 原文没有提供足以核验实际阻断率、误报率或所有场景覆盖情况的实验。
- 用 Guardian Agent 辅助调查,并不自动使它成为可信的最终权限边界;还要看外部执行点实际约束了什么。
学习路径
- 读原文 “Contain what the agent can do before it acts”,区分运行沙箱、工具访问路径和任务权限。
- 接着读 “Adapt protection as agent risk changes”,看收缩权限与直接停机之间的分级响应。
- 编辑建议的小练习:为“读取资料并生成文档”的 Agent 列出读来源、写草稿、改任务定义、对外发送四种权限,逐项写明授予条件、到期时间和执行前校验位置。
自测:风险评分模型判断“安全”,为什么仍不能代替服务器端对一次写入操作的权限校验?
检索与验证缺口
- 复现边界:本期只核查资料,没有运行机器人实验、预测训练、游戏、Skill 效果实验或安全基准。CarryoverBench 的脚本目录与 Dockerfile 页面抓取失败,运行命令来自已打开的 README。
- 资源完整性:EvoForesight 仓库的 Quick Start 尚无完整步骤;AW-0 已核查项目导读与论文,未确认完整训练代码和权重的发布状态。研究项没有找到并核实更合适的独立入门教程,学习路径优先使用作者图解。
- 时效筛选:本周检索到的 brig 沙箱文章追溯到 9 月披露;CVE-2026-114612 本周出现数据库记录,但其 LiteLLM 原始安全公告发表于 9 月 30 日,均未当作本周新漏洞收入正式选题。brig 原始披露、LiteLLM 原始公告
- 覆盖取舍:MCP 检索覆盖了官方活动、文档与实践线索,本期未选出比上述主题更值得深入的独立新项;这不代表本周没有 MCP 进展。文档方向以第 3 项可迁移的 Skill 工作法为主;娱乐创作并入第 4 项,未另凑数量。