AI 技术学习周报|2026-10-12—2026-10-18
· 本期内容由 AI 生成。
AI 生成说明: 本周报由 AI 自动检索、整理和生成,未经人工审阅(Review)。内容可能存在错误、遗漏或过时信息,请以所附原始来源为准,并自行核实重要事实。
- 交付编号: 2026-10-19
- 覆盖区间: 北京时间 2026-10-12 00:00 至 2026-10-19 00:00,不含后者。
- 实际生成: 2026-10-19(北京时间)。
- 核验范围: 已打开主要论文、官方文档、作者文章与漏洞公告;本期未执行论文实验、安装工具或运行漏洞 PoC。
本期速览
本期选入 7 个主题。技术研究、实践指南、漏洞详解分别标注性质;“本周文章”不等于“本周首次发现”。没有取得统一、可靠的互动统计,不声称这些是全网热度排名。
优先阅读
- 想理解新的训练路线:读第 1 项。 连续流语言模型怎样利用验证奖励,为什么需要 critic。
- 想改善文档工作流:读第 3 项。 把“请帮我审一下”变成可维护、有例外处理的审阅规则。
- 想理解 Agent 安全架构:读第 7 项。 代码测试通过与行为权限合规,是两道不同的关。
| 栏目 | 选题 | 本周进展与边界 |
|---|---|---|
| 技术原理 | 连续流语言模型的强化学习 | 新论文;仅在小模型与合成任务上验证 |
| 技术原理 | Weighted Ensemble 稀有事件估计 | 新论文;衡量失败概率,不直接消除失败 |
| 使用实践 | 用规则手册审阅文档并积累例外 | 10 月 16 日厂商案例;没有独立效率验证 |
| 使用实践 | 持久化人工审批与 MCP 请求的区分 | 官方文档标注 10 月 12 日更新;不声称机制首次提出 |
| 安全态势 | 携带模型权重的自复制威胁 | 受控实验;未证明真实 IoT 网络已出现自主传播 |
| 漏洞详解 | LiteLLM 配置越权与 SSRF | 本周发布技术文章;漏洞公告早于本周 |
| 安全防御 | Secure Software Factory 参考架构 | 10 月 13 日版本;架构草案,不是效果认证 |
一、技术前沿与底层原理
1. 连续流语言模型:奖励能否沿生成过程反向传播?
- 日期: 论文提交于 10 月 13 日 UTC,即北京时间 10 月 14 日。
- 进展类型: 训练方法研究,CFRL。
- 证据性质: 作者的理论分析、消融与实验,尚未由本任务复现。
- 为什么值得看: 理解语言生成不只有逐 token 预测,也理解“答案判对错”怎样影响内部训练。
核心解释
连续流语言模型先在连续的 token 表示空间里多步去噪,最后才转换成离散文字。问题是:最后答案可由程序判分,但离散解码会妨碍梯度沿生成过程传回。论文引入 critic,对中间表示的价值作可微估计,研究通过它提供训练信号。原始论文与摘要
可以把 critic 理解为给“尚未写成最终文字的中间状态”估值的模型。它提供优化方向,但估值也会出错;生成模型可能利用估值器的盲点,因此训练过程还要跟踪两者的变化。方法与训练分析,第 3—4 节
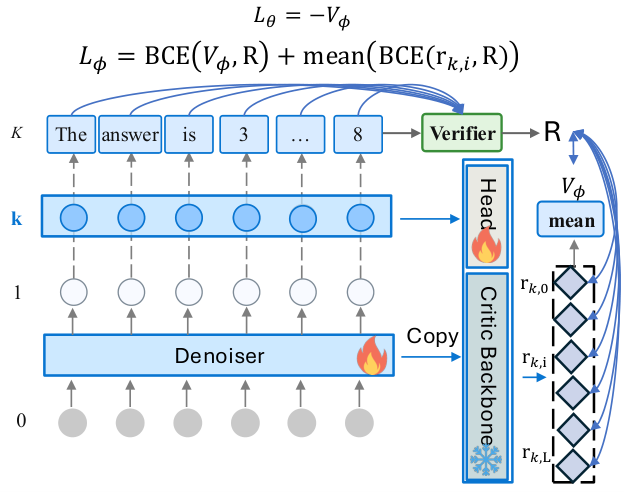
CFRL 的联合 actor–critic 训练。来源:Xu Han、Jiajing Hu、Li-Ping Liu,原论文 Figure 1,CC BY 4.0,原图未修改。
读图提示:从左侧去噪过程往上看,最终文字交给 Verifier 判分;右侧 critic 从中间表示预测价值。雪花表示冻结的骨干,火焰表示参与训练的部分。图中可微估值路径不意味着离散解码和真实验证器突然变得可微。
证据与局限
- 实验覆盖一个 105M 参数的流模型和 4 类带精确验证器的合成推理任务。
- 大模型、自然语言任务与学习型奖励尚未验证;自回归参照在其中两类任务仍领先。
- 作者写明代码与配置将发布,本次未核验到完整可运行的公开复现包;不能把论文描述当作已交付工具。限制与复现声明,第 6 节
学习路径
- 先读摘要,认识“连续表示—多步去噪—离散解码”。
- 再读全文第 3、4 节,辨别真实验证器、critic 与生成策略的职责。
- 最后读第 6 节,检查哪些结论只在受控任务中成立。未找到经核验的独立入门教程。
自测: 最终答案可以被精确判分,为什么训练时仍可能利用一个并不精确的 critic?
2. Weighted Ensemble:怎样估计“很少出现,但后果严重”的失败?
- 日期: 论文提交于 10 月 13 日 UTC,即北京时间 10 月 14 日。
- 进展类型: 稀有事件概率估计方法。
- 证据性质: 作者的理论分析与安全任务实验。
- 为什么值得看: 理解“测试没有发现失败”和“失败概率足够低”的差别。
核心解释
直接反复抽样,可能耗费大量预算仍碰不到罕见失败。Weighted Ensemble(WE)沿生成过程对前缀分组,重新分配后续采样预算,并保留样本权重;继续生成时仍使用原模型分布。最后按权重估计事件概率,不能直接统计重新采样后的失败数量。原始论文
这里的关键是把“更有效地发现少见路径”和“正确估计它们原来的概率”结合起来。论文把已有 WE 思路专门用于语言模型,并分析无偏性、方差与分组信号;它不是一个会自动让模型更安全的防御器。算法与理论,第 2 节
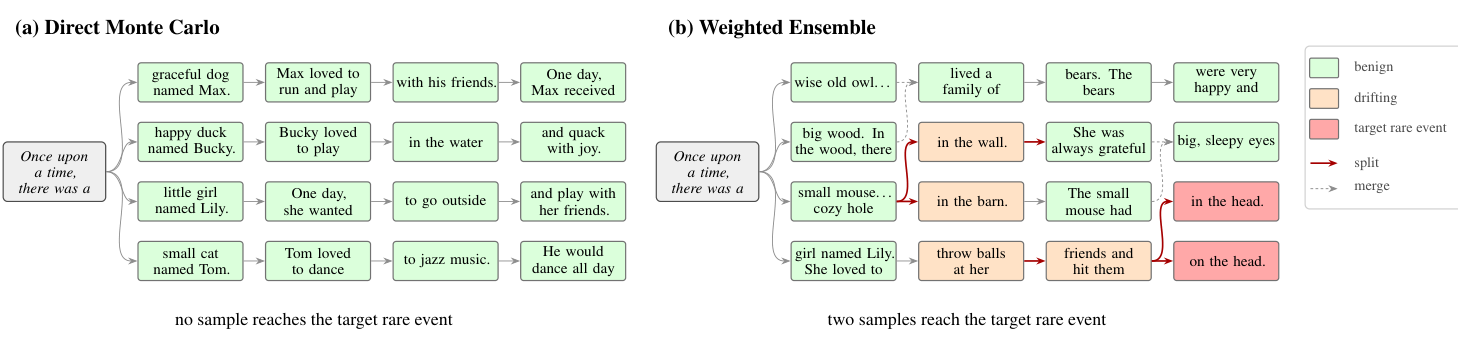
直接 Monte Carlo 与 Weighted Ensemble 的区别。来源:Zixuan Liu 等,原论文 Figure 1,CC BY 4.0。从 PDF 第 2 页提取完整图区,图内内容未改绘。
读图提示:左侧每条路径各自生成到结束;右侧虚线合并部分前缀,红线分裂更可能进入目标事件的前缀。图示解释预算如何重新分配;估计原始概率仍要使用权重,不能把右侧出现的两份目标样本直接除以样本总数。
一个独立的算术例子:假设失败概率为十万分之一,独立抽样一万次仍约有 90.5% 的概率一次都遇不到。这是假设数字的计算示例,不是论文中某模型的实测失败率。
证据与局限
- 论文证明无偏性不等于任意设置都更省样本;分组信号与预算会影响方差。
- 利用模型内部表示的变体需要白盒访问,不能原样用于所有闭源 API;框架也讨论了只用事件评分的选择。
- 事件定义与评估器可能遗漏真实风险,本次未复现实验。限制与实验设置
学习路径
- 阅读摘要,先明确它估计的量。
- 阅读全文 Algorithm 1 与第 2.3 节,跟踪一次重采样前后的权重。
- 再看限制部分与附录实验设置;暂未核验可直接运行的本方法代码入口。
自测: 把更可能失败的前缀复制更多份后,为什么不能直接把最终失败份数除以总份数?
二、编程开发与文档实践
1. 文档审阅:把偏好写成规则,让例外有去处
- 日期: Harvey 于 10 月 16 日发布实践文章。
- 进展类型: 文档审阅工作流案例,不是新模型或新协议。
- 证据性质: 厂商第一手案例与产品说明,未独立验证。
- 为什么值得看: 适合经常写技术方案、需求文档、评审材料的人,借鉴其规则维护方式。
核心解释
文章围绕 contract playbook 展开:为一种文档写明标准、可接受的替代方案、审阅指引与需要转交人工的条件;每轮草稿按规则检查,规则没有覆盖的内容也进入审阅队列。它同时强调保留规则背后的来源,并根据反复出现的例外审查规则是否需要调整。作者文章
可迁移到技术文档的地方是“把标准、例外和未覆盖项分开”,而不是照搬合同条款。以下是编辑建议,不是原作者在技术文档上的实验结论。
可照做的流程
- 从一份已认可的技术方案提取少量规则,并记录来源。
- 为每条规则定义:标准要求、允许的例外、无法判断时找谁确认。
- 让 AI 输出“满足、需人工判断、不满足、规则未覆盖”,每项附原文位置。
- 人工修改并保留变更记录。
- 只有规则负责人确认后,才将稳定的新做法写回规则;不要让 AI 为了通过检查自动放宽标准。
可用的任务描述(编辑示例):
按给定审阅规则检查这份技术方案。逐条列出规则编号、原文位置、判断和理由;不确定或没有规则覆盖的地方单列,先不要改写规则。
证据与局限
- 这是厂商案例,不把其客户效率数字当作通用收益。
- 文档质量不能完全由规则覆盖;规则本身也需要版本和人工负责人。
- 本项讨论的是文档工作方法,不对文章中的法律立场作建议。
学习路径
- 阅读原文的规则构建部分,看一条完整规则应包含什么。
- 继续看未覆盖条款与规则维护部分,思考怎么处理例外。
- 用自己的历史文档做小范围对照;以上提示词为编辑整理,不是已验证的“高赞提示词”。
自测: AI 连续多次接受同一种例外,是否足以证明应把它改成正式标准?
2. MCP 交互与持久审批:等待应放在哪一层?
- 日期: Cloudflare 官方指南标注更新于 10 月 12 日;首发时间与本次变更范围未单独核实。
- 进展类型: 本周更新的实践指南,不声称相关机制本周首次提出。
- 证据性质: 官方文档与示例,未在本任务部署。
- 为什么值得看: 适合构建需要人工参与、可能跨会话等待的 Agent 工作流。
核心解释
指南区分了三种介入层:MCP 请求中的 elicitation、应用任务中的持久 Workflow 审批,以及模型生成代码调用 connector 前的审批。它们暂停的位置和状态存储方式不同,不能只因为都显示一个确认框就混为一谈。官方对照表
其中 Workflow 的持久等待面向长期未决任务;不必让一个模型回合一直运行。对实际开发,更值得先确定“谁在等待、恢复时依据什么状态”,再选择 API。
可照做的流程
以下是编辑建议:
- 写清审批对象:一个参数输入、一次工具动作,还是整个业务任务。
- 明确审批人、待执行参数和有效期。
- 在持久状态中记录待办与决定,恢复后重新校验参数和权限。
- 用重启、拒绝、过期三种情况测试恢复行为;不能把“没有反对”当作批准。
证据与局限
- 本期确认的是指南标注的更新时间和当前内容,未证明每个示例都是本周新增。
- API 与等待语义以对应 SDK 文档为准;本次没有执行示例。
- 恢复与幂等建议为编辑整理,不能直接视作某产品自动提供的保证。
学习路径
- 从Choosing a pattern对照表确定暂停层。
- 再读 Workflow-based approval、MCP elicitation 与 Code Mode 相关章节,对比状态由谁保存。
- 先用不产生外部副作用的动作验证拒绝与过期分支,再应用到实际流程。
自测: 进程重启以后,“用户曾批准过”这件事存在哪里,又如何证明批准的就是现在这组参数?
三、Agent 与大模型安全
1. 自复制威胁:模型权重也可能成为传播载荷
- 日期: Anthropic 于 10 月 12 日公开研究。
- 进展类型: 攻击方向与能力评估。
- 证据性质: 受控实验与研究方预测,未独立复现。
- 为什么值得看: 理解“依赖中心 API 的恶意 Agent”和“在被控设备上运行权重”的威胁差别。
核心解释
研究讨论 weight-based replicator:传播载荷包含模型权重与推理环境,随后在目标设备运行模型。重点验证的是异构设备上的推理部署,以及简化网络中的步骤编排。原始研究
报告展示了把一个模型分片到 15 个廉价电视盒子上推理,但这与自主传播实验是不同部分。后者使用隔离的模拟环境、无需认证的 ADB 入口,并把较大控制模型的推理放在单独服务器上。两部分不能合并描述成“小模型已经在真实电视盒网络中独立感染和自我繁殖”。
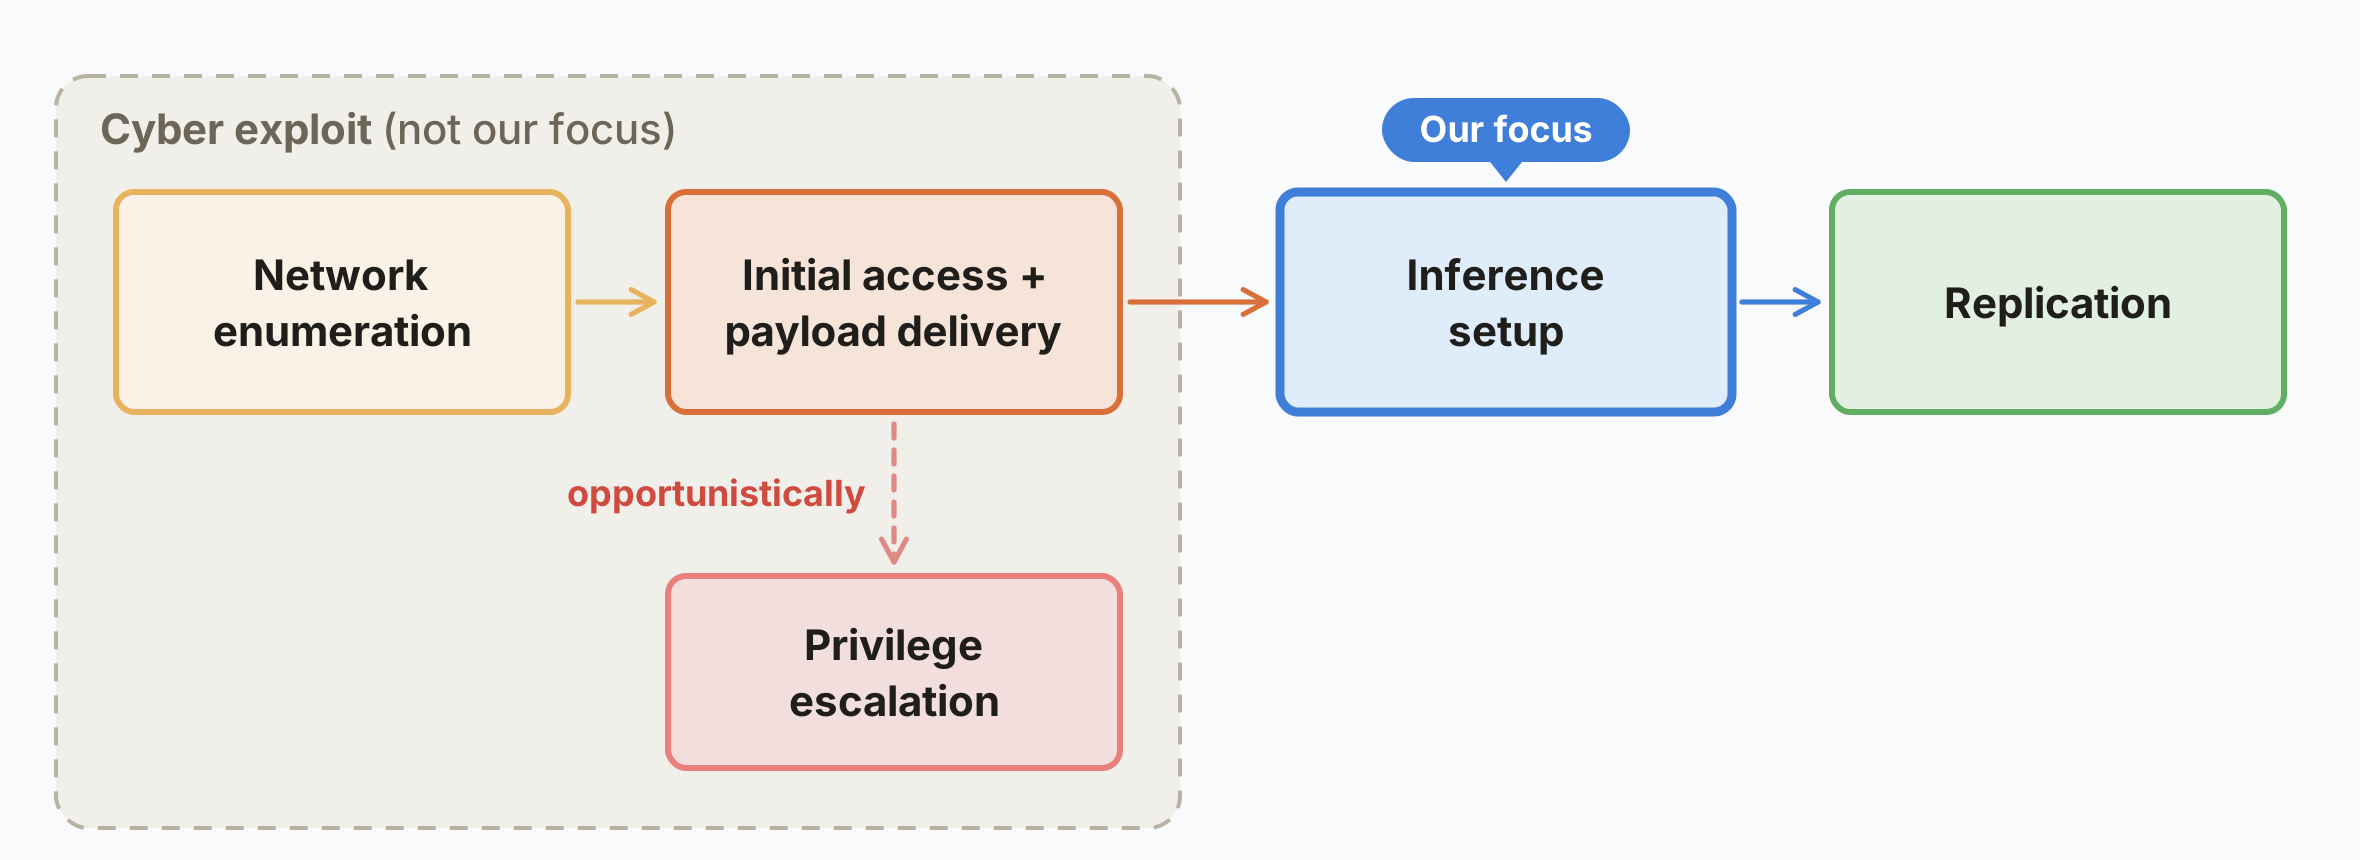
自复制链条及研究重点。来源:William Zhou、Daniel Freeman / Anthropic,原始研究的阶段示意图,原图未修改。
读图提示:从左向右分别是网络枚举、取得执行并传递载荷、部署推理环境、继续复制。蓝色“Our focus”强调这项研究重点测量推理部署;这张威胁建模图不能证明真实 IoT 网络已出现完整自主传播。
证据与局限
- “能完成单个步骤”与“能在目标设备上独立跑通端到端复制”是不同门槛。
- 年底能力预测属于研究方外推,不是已经观测到的事件。
- 这不是野外感染通报,也没有证明任意 IoT 设备都受影响。以上实验边界均来自同一研究的 Inference setup 与 Going viral 部分。
修复与防御
作为防御设计推论,除中心 API 密钥外,还应关注异常模型文件传输、推理进程与设备横向连接;撤销中心 API 访问不等于停止已经可以本地推理的载荷。具体检测规则仍需按环境验证。
学习路径
- 先读研究中的威胁分类,区分 API 型和权重型复制。
- 再读 A、B 两部分及实验限制,检查控制模型运行位置、目标入口和成功定义。
- 本次不提供或执行可传播的恶意载荷;可从隔离环境设计与能力测量方法学习。
自测: 控制模型远程指挥目标部署另一个小模型,能否直接证明这个小模型已经有自主复制能力?
2. LiteLLM:本周是技术详解,不是两个新漏洞
- 日期: Check Point 技术文章发表于 10 月 13 日;对应 GitHub 公告分别早于本周。
- 进展类型: 已披露漏洞的技术拆解与学习材料。
- 证据性质: 研究方代码分析和公开 PoC,并对照项目公告;本次未复现。
- 为什么值得看: 学习模型网关如何因传统鉴权与路由缺陷,暴露集中管理的配置和凭据。
核心解释
文章展示两条不同路径:低权限用户通过缺少角色校验的配置端点改变运行配置;请求中的 user_config 又能走到攻击者控制的路由配置。前者可连接到文件读取等影响,后者涉及 SSRF 与上游凭据泄露。这是网关应用缺陷,不应归因为模型“被越狱”。研究方技术详解与公开 PoC
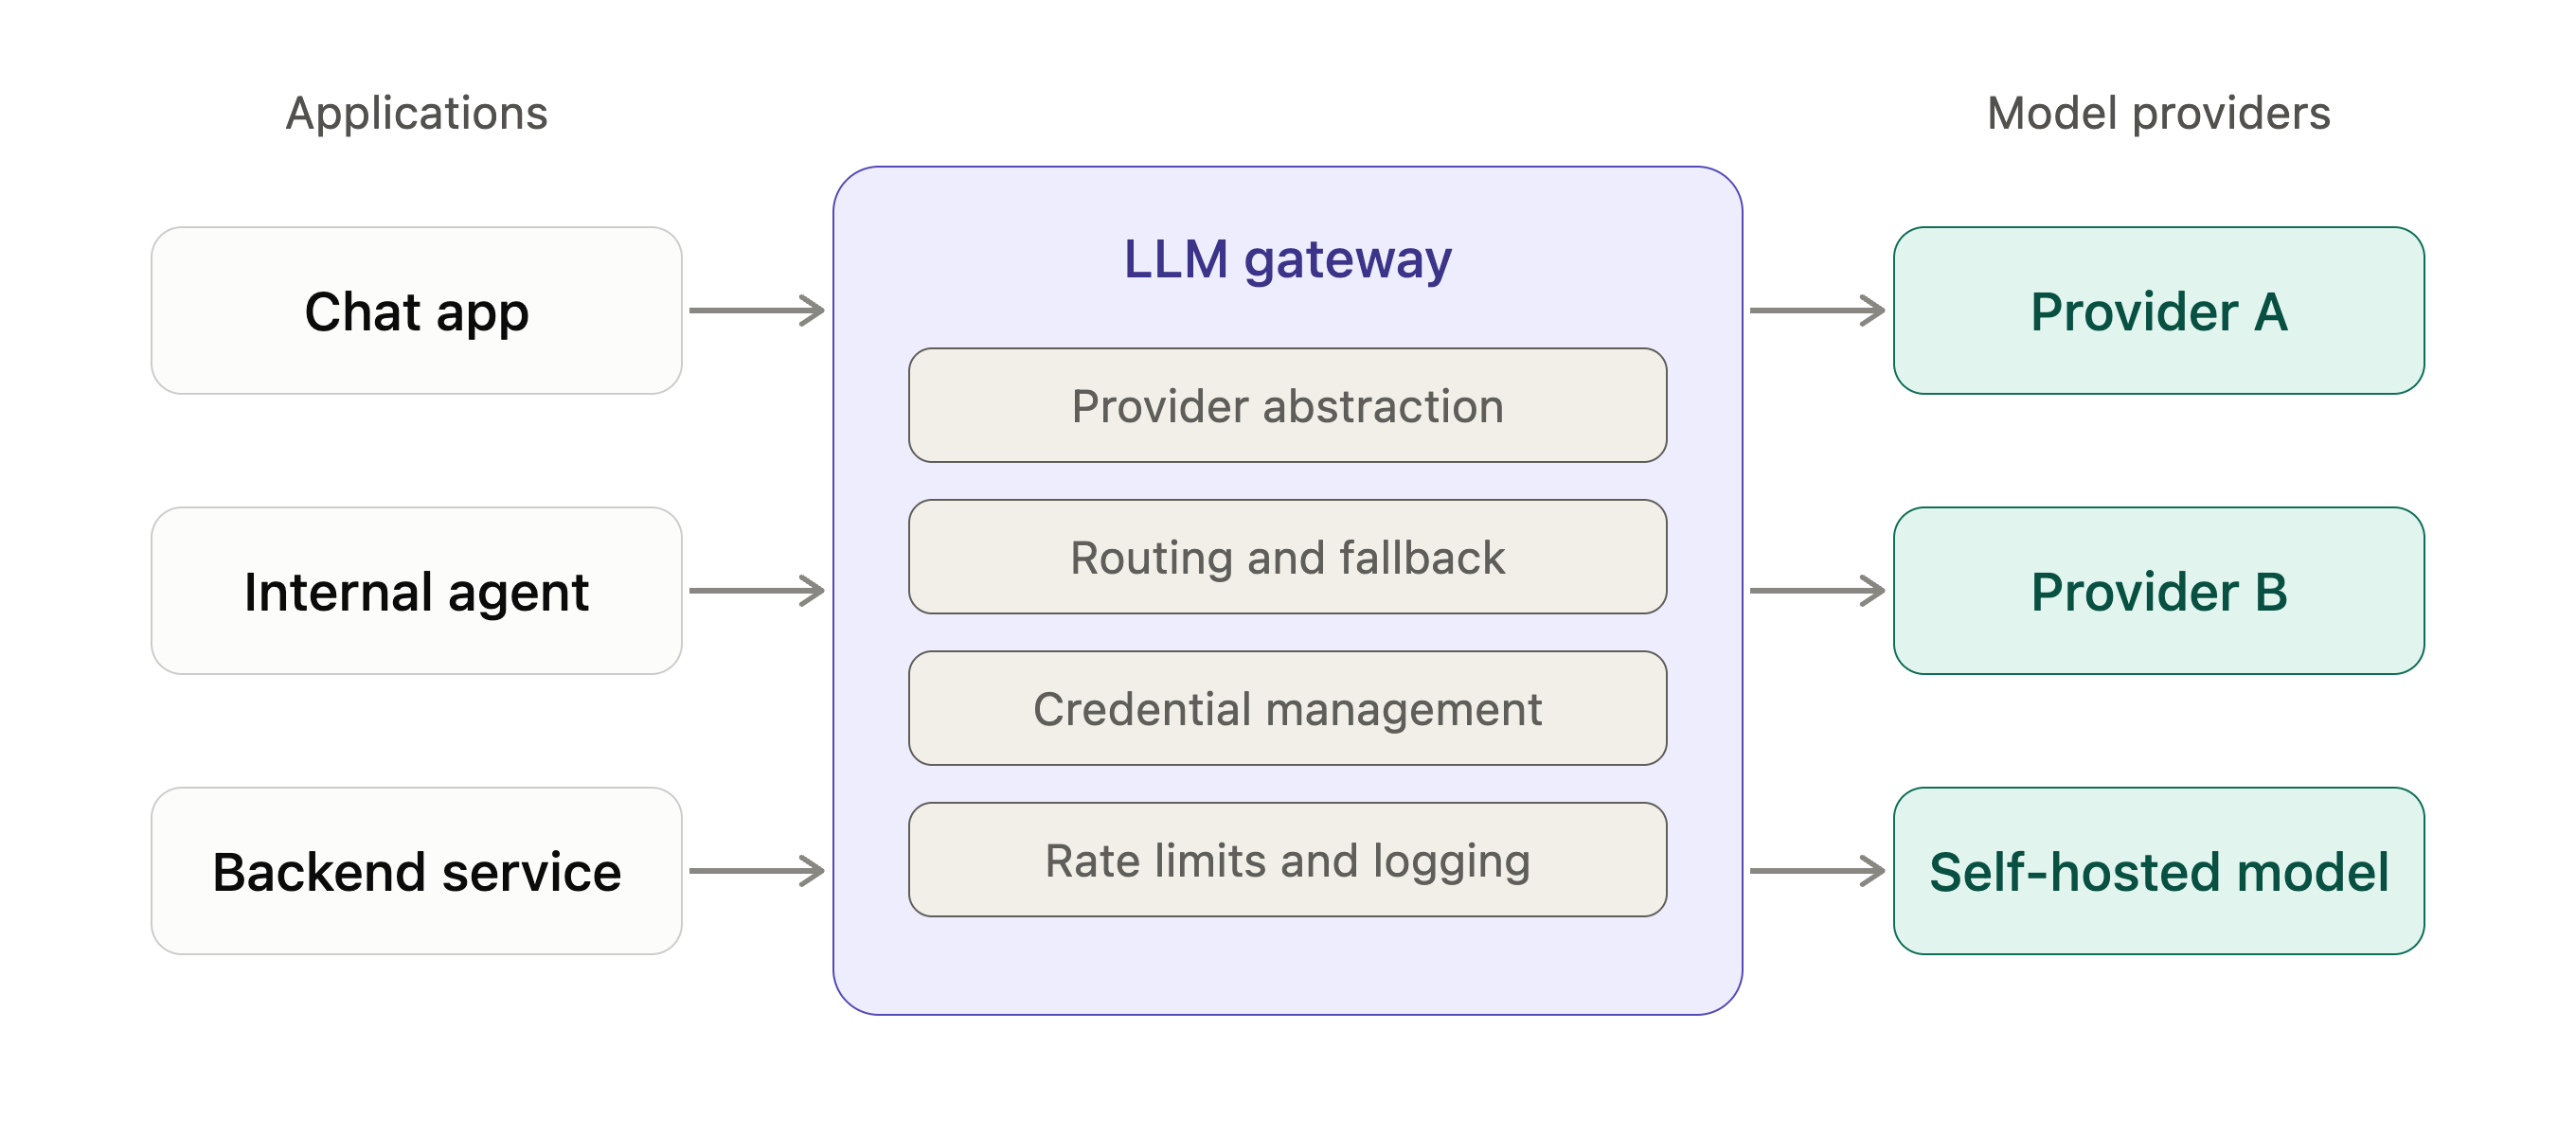
模型网关位于请求与凭据的交汇处。来源:Check Point Research,原始技术详解的网关概览图,原图未修改。
读图提示:左侧多个应用共用中间的网关,网关承担路由、凭据、限流和日志。它解释了为什么配置写权限和上游凭据需要严格隔离;这是一张组件关系图,不是两项漏洞的完整攻击链或本任务的复现结果。
证据与局限
| 漏洞 | 原公告时间 | 公告列出的受影响版本 | 修复版本 |
|---|---|---|---|
| CVE-2026-35029:配置端点越权 | 2026-04-03 | 小于 1.83.0 | 1.83.0 |
| CVE-2026-59823:user_config SSRF | 2026-08-26 | 小于等于 1.83.8 | 1.83.9 |
版本与日期来自配置越权公告和SSRF 项目公告。1.83.9 是覆盖这两项修复的历史下限,不代表今天所有安全问题的修复保证。
复现步骤
下面把公开文件读取 PoC 改成只读取自建标记文件;这是未实际执行的验证方案:
在隔离的本地旧版网关中准备可读取的 /tmp/ai-weekly-canary.txt,内容使用自定义非敏感标记。
使用本地低权限 UI 会话令牌请求配置端点。注意普通 API key 与 UI 会话的路由权限可能不同。
1
2
3
4
5
6
POST /config/update HTTP/1.1
Host: localhost:4000
Authorization: Bearer <local-low-privilege-ui-session-token>
Content-Type: application/json
{"environment_variables":{"UI_LOGO_PATH":"/tmp/ai-weekly-canary.txt"}}请求本地 GET /get_image,检查是否返回标记文件内容。
对照修复版本:低权限用户应无法完成配置更新;具体响应以运行版本为准。测试后还原测试配置。
修复与防御
- 依据部署版本对照项目公告,升级并确认实际加载的镜像和依赖。
- 将角色鉴权落实到写配置端点,不能把“已登录”视为管理员权限。
- 限制用户自定义路由到达的目标,并区分用户提供的参数与服务端管理的上游凭据。
学习路径
自测: 同样是合法令牌,为什么“允许打开配置页面”不应自动变成“允许修改全部配置”?
3. Secure Software Factory:让权限约束位于 Agent 决策之外
- 日期: 参考架构版本 1 发布于 10 月 13 日;基础 Agent Baseline 早于本周。
- 进展类型: 新防御参考架构。
- 证据性质: 开放征求意见的设计文档,不是独立效果评测。
- 为什么值得看: 把沙箱、联网、供应链和身份权限放进同一张架构图,而不只研究提示词过滤。
核心解释
架构提出四条由 Agent 外部基础设施执行的边界:
- 沙箱: 代码在哪里运行。
- 网络: 能触达哪些系统和操作。
- 供应链: 能引入哪些组件与来源。
- 身份和权限: 代表谁、对哪些资源执行哪些动作。
边界在人工编排、固定工作流编排和 Agent 自主编排三种模式下都需要存在;自主程度提高不等于自动扩大权限。架构概览与发布日期
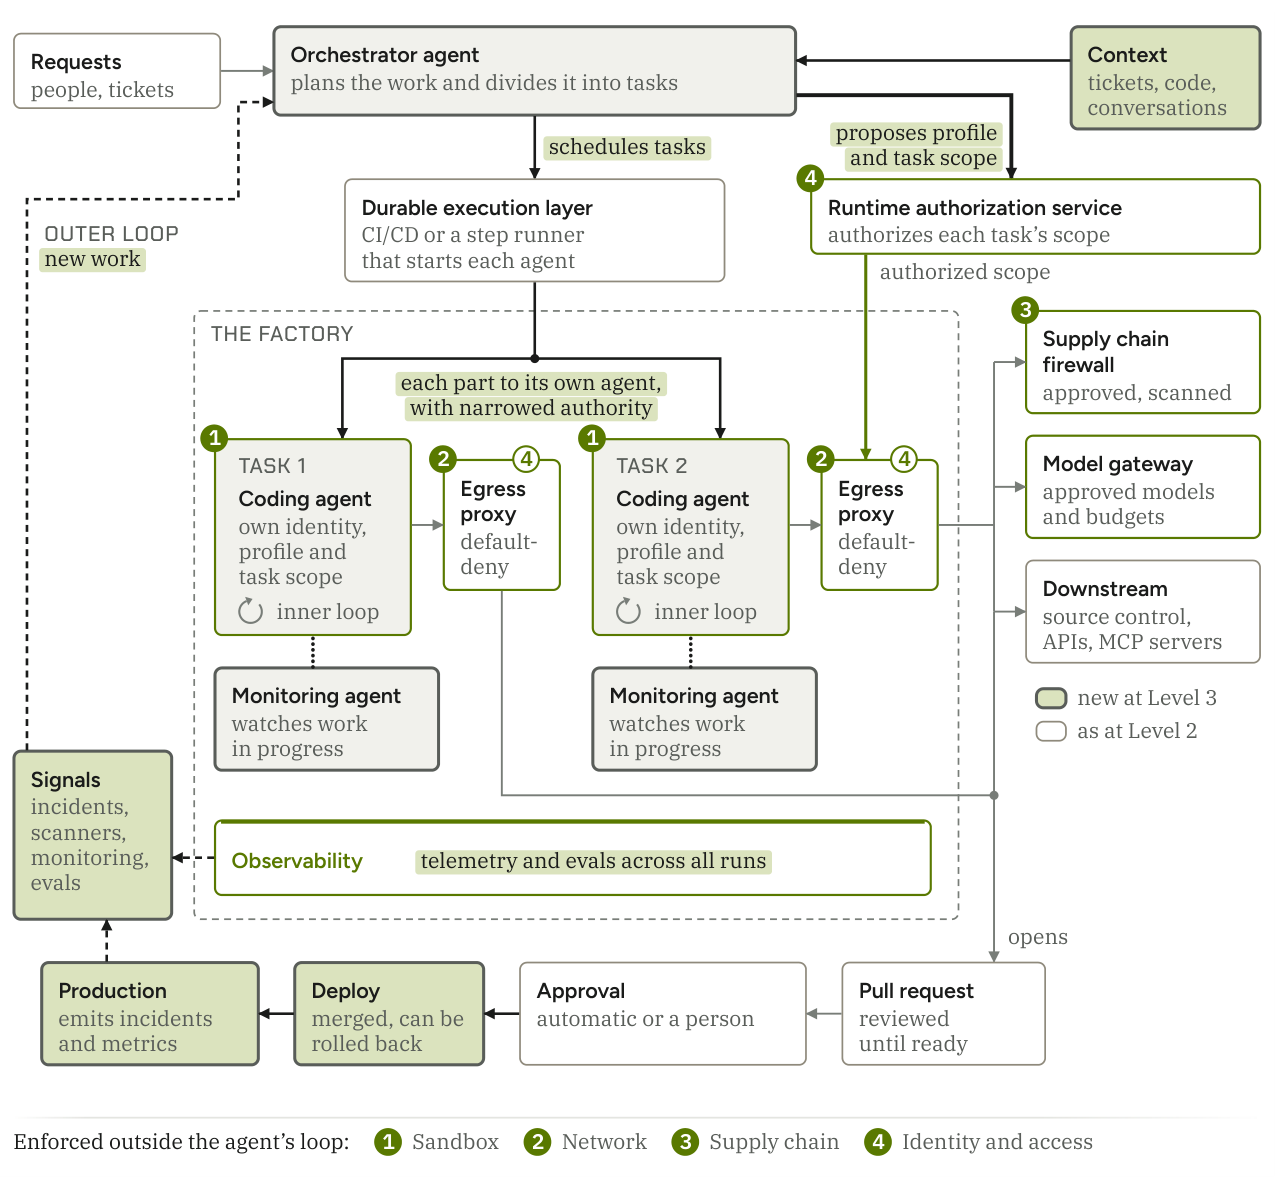
Agent 自主编排时,权限仍由外部设施约束。来源:Agent Baseline 参考架构作者,版本 1,Figure 5,CC BY 4.0。从 PDF 第 13 页提取完整图区及边界图例,图内内容未改绘。
读图提示:先看上方:Orchestrator 提出任务范围,Runtime authorization service 才授权;再看下方图例中的 1—4,分别对应沙箱、网络、供应链、身份与访问。连线展示架构责任,不能当作这些控制已部署或安全效果已验证的证明。
一个值得带回日常开发的判断是:测试通过只能说明检查覆盖的代码行为符合预期,不能证明 Agent 在实现过程中没有越权访问其他系统。
证据与局限
- 这是参考架构草案,未提供一套可以直接证明安全收益的通用基准结果。
- 来源可追溯不等于组件安全;限制执行环境也不能证明自然语言输入绝无注入。
- 本期只介绍设计和学习入口,没有部署或验证任一实现。原始架构源文档
可照做的流程
以下为编辑建议:
- 为一个编码任务画出工作目录、网络出口、组件下载入口与执行身份。
- 检查这些控制能否被 Agent 自己改写,或者从其他路径绕开。
- 用一次明确越界但无破坏性的请求验证控制是否生效,记录实际行为。
- 将“结果正确”和“执行没有越权”分别验收。
学习路径
自测: 如果一个沙箱能由 Agent 自己关闭网络代理,代理还能算独立于 Agent 的安全边界吗?
四、娱乐与艺术
本期不设正式选题。检索到一份 10 月 16 日的动画制作复盘,但全文获取失败,未据搜索摘要整理制作步骤或推荐效果。
本期检索与验证缺口
- 未获得可比较的本周点赞、收藏或传播统计;按来源与学习价值筛选,不把仓库累计 star 当作本周热度。
- 未核验到符合时间与证据要求的新 Skill 分享,不据目录的“新收录”时间推断项目首发。
- Prime Agent 原作者文章标注 8 月 5 日;Addy Osmani 的 Agentic Code Quality 原文标注 8 月 8 日。没有将本周汇总或再刊当成原始首发。
- Cloudflare 指南只确认本周更新时间,未核实各段落具体新增日期;已按指南更新标注。
- LiteLLM 本周内容仅为技术详解,相关漏洞原始日期和版本已单列,未宣称新发现或零日。
- 研究指标均为作者报告,工具和 PoC 未运行;独立复现、白盒访问要求和生产环境迁移仍需进一步验证。